# 如何下载包
npm install @版本(版本可省略,默认为最新版本)( install 可简写为 i)- 执行下载命令的时候可以添加一些命令参数 (参数不加的默认是依赖包)
- –save 参数 项目必须依赖包 (dependencies) 安装的参数
- -S 项目必须依赖包 (dependencies) 安装的参数
- –save-dev 参数 项目工具包 (devDependencies) 安装的参数
- -D 项目工具包 (devDependencies) 安装的参数
- -g 全局安装
npm i可以将之前下记录在 package.json 中的所有包全部下载下来。所以说项目合作的时候只需删除 node_modules 文件夹即可dependencies:{"md5":"^2.1.0"}^表示:如果直接 npm install 将会安装 md52.x.x最新版本,dependencies:{"md5":"~2.1.0"}~表示:如果直接 npm install 将会安装 md52.1.x最新版本,dependencies:{"md5":"*"}*表示:如果直接 npm install 将会安装 md5 最新版本
# 初识 Node.js
Node.js 是 一个基于 Chrome V8 引擎的 JavaScript 运行环境
# 运行环境
浏览器是 Javascript 的前端运行环境Node.js是 Javascript 的后端运行环境- Node.js 中
无法调用DOM 和 BOM 等浏览器内置 API
# 可以做什么
- 基于 Express (http://www.expressjs.com.cn/) 框架,可以快速构建 Web 应用
- 基于 Electron 框架 (https://electronjs.org/),可以构建跨平台的桌面应用
- 基于 restify 框架 (http://restify.com/),可以快速构建 API 接口项目
- 读写和操作数据库、创建实用的命令行工具辅助前端开发……
# 学习路径
Javascript 基础语法 + Node.js 内置 API 模块 (fs、path、http 等) + 第三方 API 模块 (express、mysql 等)
# 如何在 Node.js 中运行 Js 代码
- 打开终端,输入
node 要执行的js文件的路径 - 找到对应文件夹,shift + 右键 (在此处打开 powershell)
- 在地址栏输入 cmd 也可以
# fs 文件系统模块
# 什么是 fs 文件系统模块
fs 模块 是 Node.js 官方提供的、用来操作文件的模块。它提供了一系列的方法和属性,用来满足用户对文件的操作需求。
例如:
- fs.readFile () 方法,用来
读取指定文件中的内容 - fs.writeFile () 方法,用来向指定的文件中
写入内容
如果要在 Javascript 代码中,使用 fs 模块来操作文件,则需要使用如下的方式先导入它:
const fs = require("fs");# 读取指定文件中的内容
-
fs.readFile () 的语法格式
使用 fs.readFile () 方法,可以读取指定文件中的内容,语法格式如下:
fs.readFile(path[,options],callback)参数 1:
必选参数,字符串,表示文件的路径
参数 2:可选参数,表示以什么编码格式来读取文件
参数 3:必选参数,文件读取完成后,通过回调函数拿到读取的结果 -
示例代码
const fs = require("fs"); fs.readFile("./files/1.txt", "utf8", function (err, dataStr) { console.log(err); console.log("-----"); console.log(dataStr); }); // 1.txt 中写有111 // 如果读取成功,则err的值为 null // 如果读取失败,则err的值为错误对象,dataStr的值为 undefined -
判断文件是否读取成功
const fs = require("fs");
fs.readFile("./files/1.txt", "utf8", function (err, result) {
  if (err) {
    return console.log("文件读取失败:" + err.message);
    // 文件读取失败:ENOENT: no such file or directory, open 'c:\Users\13610\Desktop\node\files\11.txt'
  }
  console.log("文件读取成功,内容是" + result);
  // 文件读取成功,内容是 111
});
# 向指定文件中写入内容
-
fs.writeFile () 的语法格式
使用 fs.writeFile () 方法,可以向指定的文件中写入内容,语法格式如下:
fs.writeFile(file,data[,options],callback)参数 1:
必选参数,需要指定一个文件路径的字符串,表示文件的存放路径
参数 2:必选参数,表示要写入的内容
参数 3:可选参数,表示以什么格式写入文件内容,默认值是 utf8
参数 4:必选参数,文件写入完成后的回调函数 -
示例代码
const fs = require("fs"); // 这里的2.txt不用提前创建,writeFile会自动创建 fs.writeFile("./files/2.txt", "Hello Node.js", function (err) { // 如果文件写入成功,则 err 的值为 null // 如果文件写入失败,则 err 的值为一个错误对象 console.log(err); }); -
判断文件是否读取成功
const fs = require("fs");
fs.writeFile("f:/files/2.txt", "Hello Node.js", function (err) {
  if (err) {
    return console.log("文件写入失败:" + err.message);
  }
  console.log("文件写入成功");
});
// 文件写入失败:ENOENT: no such file or directory, open 'f:\files\2.txt'
# 练习–考试成绩整理
使用 fs 文件系统模块,将素材目录下 成绩.txt 文件中的考试数据,整理到 成绩-ok.txt 文件中
整理前, 成绩.txt 文件中的数据格式如下:
小红=99 小白=100 小黄=70 小黑=66 小绿=88整理完成之后,希望得到的 成绩-ok.txt 文件中的数据格式如下:
小红:99
小白:100
小黄:70
小黑:66
小绿:88-
练习.js
const fs = require("fs");
fs.readFile("./files/成绩.txt", "utf8", function (err, result) {
  if (err) {
    return console.log("读取文件失败" + err.message);
  }
  // console.log("读取文件成功" + result);
  const arrOld = result.split(" ");
  const arrNew = [];
  arrOld.forEach((item) => {
    arrNew.push(item.replace("=", ":"));
  });
  // \r\n 代表换行回车
  const newResult = arrNew.join("\r\n");

  fs.writeFile("./files/成绩-ok.txt", newResult, function (err) {
    if (err) {
      return console.log("写入成绩失败:" + err.message);
    }
    console.log("成绩写入成功!");
  });
});
# 路径动态拼接的问题
在使用 fs 模块操作文件时,如果提供的操作路径是以 ./ 或 ../ 开头的 相对路径 时,很容易出现动态拼接错误的问题。
原因:代码在运行的时候, 会以执行 node 命令时所处的目录 ,动态拼接出被操作文件的完整路径。
__dirname:表示当前文件所处的目录,它所代表的值不会跟着咱们执行 node 命令时,所处的目录而动态变化(个人理解相当于 pwd)
// 一定要在正确的目录下运行代码
const fs = require("fs");
// __dirname 表示当前文件所处的目录,这里要将./变成/,否则会出错
fs.readFile(__dirname + "/files/1.txt", "utf8", function (err, result) {
  if (err) {
    return console.log("读取文件失败" + err.message);
  }
  console.log("读取文件成功" + result);
  // /c/Users/13610/Desktop/node/files/1.txt
});
# 具体 api 案例
const fs = require("fs");
// 创建文件夹
fs.mkdir("./logs", (err) => {
  console.log("done.");
});
// 文件夹改名
// logs 是原来要修改的名字,log 是要改为的名字
fs.rename("./logs", "./log", (err) => {
  console.log("done");
});
// 删除文件夹
// 如果文件夹下有文件,执行这个命令是删不掉的。应该先使用 unlink 把文件夹下的问价删掉,然后再执行 rmdir
fs.rmdir("./log", (err) => {
  console.log("done.");
});
// 写内容到文件里
fs.writeFile(
  "./logs/log1.txt",
  "hello",
  // 这里是覆盖文件之前的内容
  // 错误优先的回调函数
  (err) => {
    if (err) {
      console.log(err.message);
    } else {
      console.log("文件创建成功");
    }
  }
);
// 给文件追加内容
fs.appendFile("./logs/log1.txt", "\nworld", (err) => {
  // 在原有文件基础上,新追加内容
  console.log("done.");
});
// 读取文件内容
fs.readFile("./logs/log1.txt", "utf-8", (err, data) => {
  // 或者readFile不加'utf-8'第二个参数,直接用 data.toString('utf-8')也可以
  console.log(data);
});
// 删除文件
fs.unlink("./logs/log1.txt", (err) => {
  console.log("done.");
});
// 批量写文件
for (var i = 0; i < 10; i++) {
  fs.writeFile(`./logs/log-${i}.txt`, `log-${i}`, (err) => {
    console.log("done.");
  });
}
// 读取文件/目录信息(可以获取对应目录下有多少个文件)
fs.readdir("./", (err, data) => {
  data.forEach((value, index) => {
    // stat 可以获取文件的大小,创建时间,还能告诉我们是文件还是一个目录
    fs.stat(`./${value}`, (err, stats) => {
      // console.log(value + ':' + stats.size)
      // isDirectory 可以知道是不是目录,isFile 可以知道是不是文件
      console.log(
        value + " is " + (stats.isDirectory() ? "directory" : "file")
      );
    });
  });
});
// 同步读取文件
// 加了Sync就是同步方法
try {
  const content = fs.readFileSync("./logs/log-1.txt", "utf-8");
  console.log(content);
  console.log(0);
} catch (e) {
  console.log(e.message);
}
// 在 fs 模块中,提供同步方法是为了方便使用。那我们到底是应该用异步方法还是同步方法呢?
// 由于Node环境执行的JavaScript代码是服务器端代码,所以,绝大部分需要在服务器运行期反复执行业务逻辑的代码,必须使用异步代码,否则,同步代码在执行时期,服务器将停止响应,因为JavaScript只有一个执行线程。服务器启动时如果需要读取配置文件,或者结束时需要写入到状态文件时,可以使用同步代码,因为这些代码只在启动和结束时执行一次,不影响服务器正常运行时的异步执行。

// 异步读取文件:方法一
fs.readFile("./logs/log-0.txt", "utf-8", (err, content) => {
  console.log(content);
  console.log(0);
});
console.log(1);

// 异步读取文件:方法二
const fs = require("fs").promises;
fs.readFile("./logs/log-0.txt", "utf-8").then((result) => {
  console.log(result);
});

// 批量删除文件夹下的文件
const fs = require("fs").promises;
fs.readdir("./avatar").then(async (data) => {
  let arr = [];
  data.forEach((item) => {
    arr.push(fs.unlink(`./avatar/${item}`));
  });
  await Promise.all(arr);
  await fs.rmdir("./avatar");
});
# path 路径模块
# 什么是 path 路径模块
path 模块 是 Node.js 官方提供的,用来 处理路径 的模块。它提供了一系列的方法和属性,用来满足用户对路径的处理需求。
例如:
path.join()方法,用来将多个路径片段拼接成一个完整的路径字符串path.basename()方法,用来从路径字符串中,将文件名解析出来
如果要在 Javascript 代码中,使用 path 模块来处理路径,则需要使用如下的方式先导入它:
const path = require("path");# 路径拼接 path.join ()
使用 path.join () 方法,可以把多个路径片段拼接为完整的路径字符串,语法格式如下:
path.join([...paths]);参数解读:
-
…paths
:路径片段的序列 -
返回值:
-
path.join 方法.js
const path = require("path");

// ../ 会抵消一层路径,会把紧挨着他前边的那个路径抵消掉,所以不包含c
const pathStr = path.join("/a", "/b/c", "../", "./d", "e");
console.log(pathStr); // \a\b\d\e

const pathStr2 = path.join("/a", "/b/c", "../../", "./d", "e");
console.log(pathStr2); // \a\d\e

const pathStr3 = path.join(__dirname, "./files/1.txt");
console.log(pathStr3); // c:\Users\13610\Desktop\node\files\1.txt

fs.readFile(path.join(__dirname, "./files/1.txt"), "utf8", function (
  err,
  dataStr
) {
  if (err) {
    return console.log(err.message);
  }
  console.log(dataStr); // 这里会进行输出
});
注意: 今后凡是涉及到路径拼接的操作,都要使用 path.join() 方法进行处理 ,不要直接使用 + 进行字符串的拼接
# 获取路径中的文件名 path.basename ()
使用 path.basename () 方法,可以获取路径中的最后一部分,经常通过这个方法获取路径中的文件名,语法格式如下:
path.basename(path[,ext])参数解读:
-
path
:必选参数,表示一个路径的字符串 -
ext
:可选参数,表示文件扩展名 (只希望拿到文件名,不希望拿到扩展名) -
返回
表示路径中的最后一部分 -
path.basename 方法.js
const path = require("path");

// 定义文件的存放路径
const fpath = "/a/b/c/index.html";

// 可以获取完整的文件名
const fullName = path.basename(fpath);
console.log(fullName); // index.html

// 不希望获取到后缀名,只希望拿到文件名
// 这里是将文件名中的指定后缀名(.html)给移除掉,只保留文件名
const nameWithoutExt = path.basename(fpath, ".html");
console.log(nameWithoutExt); // index
# 获取路径中的文件扩展名 path.extname ()
使用 path.extname () 方法,可以获取路径中的扩展名部分,语法格式如下:
path.extname(path);参数解读:
-
path
:必选参数,表示一个路径的字符串 -
返回
返回得到的扩展名字符串 -
path.extname 方法.js
const path = require("path");

const fpath = "/a/b/c/index.html";

const fext = path.extname(fpath);
console.log(fext); // .html
# 时钟案例
-
时钟案例.js
const fs = require("fs"); const path = require("path"); // 定义正则表达式,匹配style和script标签 // \s:空白字符 \S:非空白字符 *:代表可以出现任意多次 const regStyle = /<style>[\s\S]*<\/style>/; const regScript = /<script>[\s\S]*<\/script>/; // 调用fs.readFile()方法读取文件 fs.readFile(path.join(__dirname, "./时钟/index.html"), "utf8", function ( err, dataStr ) { if (err) { return console.log("文件读取失败!" + err.message); } // 读取文件成功后,调用对应的三个方法,分别拆解出 css,js,html 文件 resolveCSS(dataStr); resolveJS(dataStr); resolveHTML(dataStr); }); // 处理css function resolveCSS(htmlStr) { // 使用正则提取需要的内容 const r1 = regStyle.exec(htmlStr); // 将提取出来的样式字符串,进行字符串的 replace 替换操作 const newCss = r1[0].replace("<style>", "").replace("</style>", ""); // 这里进行写操作的时候,要有clock文件夹 // 调用fs.writeFile()方法, 将提取出来的样式写入到block目录中的index.css文件中 fs.writeFile( path.join(__dirname, "./时钟/clock/index.css"), newCss, function (err) { if (err) return console.log("写入样式文件失败!" + err.message); console.log("写入样式文件成功!"); } ); } // 处理js function resolveJS(htmlStr) { // 使用正则提取需要的内容 const r2 = regScript.exec(htmlStr); // 将提取出来的脚本字符串,进行字符串的 replace 替换操作 const newJs = r2[0].replace("<script>", "").replace("</script>", ""); // 这里进行写操作的时候,要有clock文件夹 // 调用fs.writeFile()方法, 将提取出来的脚本写入到block目录中的index.js文件中 fs.writeFile( path.join(__dirname, "./时钟/clock/index.js"), newJs, function (err) { if (err) return console.log("写入脚本文件失败!" + err.message); console.log("写入脚本文件成功!"); } ); } // 处理html function resolveHTML(htmlStr) { // 将字符串调用 replace 方法,把内嵌的 style 和 script 标签,替换为外联的 link 和 script 标签 // 这里要写 ./index.css 和 ./index.js,注意这是以写完之后的index.html为参考写的路径 const newHTML = htmlStr .replace(regStyle, "<link rel='stylesheet' href='./index.css'></link>") .replace(regScript, "<script src='./index.js'></script>"); // 写入clock中的 index.html 文件 fs.writeFile( path.join(__dirname, "./时钟/clock/index.html"), newHTML, function (err) { if (err) console.log("写入HTML文件失败!" + err.message); console.log("写入HTML文件成功!"); } ); } -
注意点:
fs.writeFile()方法只能创建文件,不能创建路径(需要提前有对应的文件夹)- 重复调用
fs.writeFile()写入同一个文件,新写入的内容会覆盖之前的旧内容
# http 模块
# 什么是 http 路径模块
# 什么是 客户端 和 服务器
在网络节点中,负责消费资源的电脑,叫做 客户端 ;负 责对外提供网络资源 的电脑,叫做 服务器
http 模块 是 Node.js 官方提供的,用来 创建 web 服务器 的模块。通过 http 模块提供的 http.createServer() 方法,就能方便的把一台普通的电脑,变成一台 Web 服务器,从而对外提供 Web 资源服务。
如果要希望使用 http 模块创建 Web 服务器,则需要先导入它:
const http = require("http");# 进一步理解 http 模块的作用
服务器和普通电脑的 区别 在于,服务器上安装了 web 服务器软件 ,例如:IIS, Apache 等,通过安装这些服务器软件,就能把一台普通的电脑变成一台 web 服务器。
在 Node.js 中,我们 不需要使用 IIS,Apache 等这些 第三方 web 服务器软件 。因为我们可以基于 Node.js 提供的 http 模块, 通过几行简单的代码,就能轻松的手写一个服务器软件 ,从而对外提供 web 服务器。
# 服务器相关概念
# IP 地址
IP 地址 就是互联网上 每台计算机的唯一地址 ,因此 IP 地址具有唯一性,如果把 "个人电脑" 比作 "一台电话",那么 "IP 地址" 就相当于 "电话号码",只有在知道对方 IP 地址的前提下,才能与对应的电脑之间进行数据通信。
IP 地址的格式:通常用 " 点分十进制 " 表示成 ( a.b.c.d ) 的形式,其中,a,b,c,d 都是 0-255 之间的十进制整数,例如:用点分十进制表示的 IP 地址 (192.168.1.1)
注意:
互联网中每台 Web 服务器,都有自己的 IP 地址,例如:大家可以在终端中运行ping www.baidu.com命令,即可查看到百度服务器的 IP 地址- 在开发期间,自己的电脑既是一台服务器,也是一个客户端,为了方便测试,可以在自己的浏览器中输入 127.0.0.1 这个 IP 地址,就能把自己的电脑当做一台服务器进行访问了。
# 域名和域名服务器
尽管 IP 地址能够唯一标记网络上的计算机,但 IP 地址是一长串数字, 不直观 ,而且 不便于记忆 ,于是人们又发明了另一套 字符型 的 地址方案 ,即所谓的 域名(Domain Name)地址 。
IP 地址 和 域名 是 一一对应的关系 ,这份对应关系存放在一种叫做 域名服务器 (DNS) 的电脑中。使用者只需通过好记的域名访问对应的服务器即可,对应的转换工作由域名服务器实现。因此, 域名服务器就是提供 IP 地址和域名之间的转换服务的服务器 。
注意:
- 单纯使用 IP 地址,互联网中的电脑也能够正常工作,但是有了域名的加持,能让互联网的世界变得更加方便。
- 在开发测试期间,
127.0.0.1对应的域名是localhost,它们都代表我们自己的这台电脑,在使用效果上没有任何区别。
# 端口号
计算机中的端口号,就好像是现实生活中的门牌号一样,通过门牌号,外卖小哥可以在整栋大楼众多的房间中,准确把外卖送到你的手中。
同样的道理,在一台电脑中,可以运行成百上千个 web 服务。每个 web 服务都对应一个唯一的端口号。客户端发送过来的网络请求,通过端口号,可以被准确地交给 对应的 web 服务 进行处理。
注意:
- 每个端口号不能同时被多个 web 服务占用。
- 在实际应用中,URL 中只有 80 端口可以被省略。
# 创建最基本的 web 服务器
-
案例.js
const http = require("http");
const server = http.createServer();
server.on("request", function (req, res) {
  console.log("someone visit our web server.");
});
server.listen(8080, function () {
  console.log("server running at:http:127.0.0.1:8080");
});
# req 请求对象 和 res 响应对象
-
req 请求对象:
只要服务器接收到了客户端的请求,就会调用通过
server.on()为服务器绑定的request 事件处理函数。如果想在事件处理函数中,访问与客户端相关的数据或属性,可以使用如下的方式:const http = require("http"); const server = http.createServer(); server.on("request", (req) => { // req 是请求对象,它包含了与客户端相关的数据和属性,例如: // req.url 是客户端请求的 URL 地址(/以及/之后的地址) // 举例:比如我请求地址是127.0.0.1,那它就是 /,如果是127.0.0.1/index.html,那它就是 /index.html // req.method 是客户端的 method 请求类型 const str = `Your request url is ${req.url}, and request method is ${req.method}`; console.log(str); }); server.listen(80, () => { console.log("server running at http://127.0.0.1"); }); -
res 响应对象:
在服务器的 request 事件处理函数中,如果想访问与服务器相关的数据或属性,可以使用如下的方式:const http = require("http"); const server = http.createServer(); server.on("request", (req, res) => { const str = `Your request url is ${req.url}, and request method is ${req.method}`; // res 是响应对象,它包含了与服务器相关的数据和属性,例如要发送到客户端的字符串 // res.end() 方法的作用:向客户端发送指定的内容,并结束这次请求的处理过程 // 调用 res.end() 方法,向客户端响应一些内容 res.end(str); }); server.listen(80, () => { console.log("server running at http://127.0.0.1"); }); -
解决
中文乱码问题
当调用 res.end () 方法,向客户端发送中文内容的时候,会出现乱码问题,此时,需要手动设置内容的编码格式:const http = require("http"); const server = http.createServer(); server.on("request", (req, res) => { const str = `您请求的地址是 ${req.url},请求的method类型是 ${req.method}`; res.setHeader("content-Type", "text/html; charset=utf-8"); // 调用 res.end() 方法,向客户端响应一些内容 res.end(str); }); server.listen(80, () => { console.log("server running at http://127.0.0.1"); });
# 根据不同的 URL 响应不同的 HTML 内容
const http = require("http");
const server = http.createServer();
server.on("request", (req, res) => {
  let url = req.url;
  let context = `<h1>404 NOT FOUND!</h1>`;
  if (url === "/" || url === "/index.html") {
    context = `<h1>首页</h1>`;
  } else if (url === "/about.html") {
    context = `<h1>关于首页</h1>`;
  }
  res.setHeader("Content-Type", "text/html; charset=utf-8");
  res.end(context);
});
server.listen(80, () => {
  console.log("server running at http:127.0.0.1");
});
# 实现 clock 时钟的 web 服务器
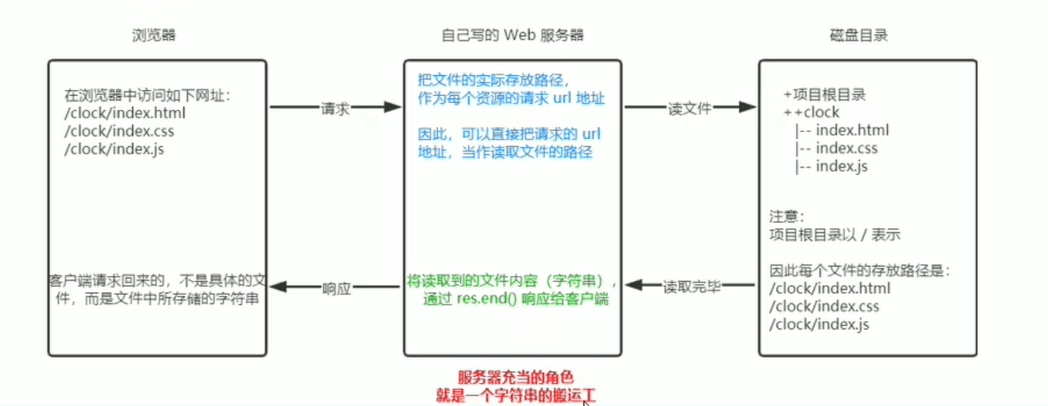
核心思想:把文件的 实际存放路径 , 作为 每个资源的 请求 url 地址 ,服务器充当的角色就是要给字符串的搬运工
-
案例.js
const http = require("http");
const fs = require("fs");
const path = require("path");

const server = http.createServer();

server.on("request", (req, res) => {
  // 获取客户端请求的url地址
  let url = req.url; // 比如/clock/index.html
  // 把请求的url地址映射为本地文件的存放路径
  let fpath = ""; //映射为 本地文件存放路径/clock/index.html
  if (url === "/") {
    // 如果请求的路径是/,则手动指定文件的存放路径
    fpath = path.join(__dirname, "./clock/index.html");
  } else {
    // 如果请求的路径不是 /,则动态拼接文件的存放路径
    fpath = path.join(__dirname, "./clock", url);
  }

  // 根据'映射'过来的文件路径读取文件的内容
  fs.readFile(fpath, "utf8", function (err, dataStr) {
    if (err) return res.end("404 NOT FOUND!");
    if (url === "/clock/index.html") {
      // 可以在index.html中单独进行设置
      // 如果没在这里进行单独设置,其他位置有这行的话,css样式会不生效
      res.setHeader("Content-Type", "text/html; charset=utf-8");
    }
    res.end(dataStr);
  });
});
server.listen(80, () => {
  console.log("server running at http:127.0.0.1");
});
# write,send,json,end
- write,send,json 都是响应正文的方法
- res.write:向客户端返回的数据没有经过处理,返回了什么就是什么,
- res.send:send 向客户端返回的数据被处理了,在请求头中被添加了
context-type返回类型, - res.json:就是相当于手动设置了下
Content-Type:application/json;它只是告诉浏览器返回数据类型是 json,并不帮忙转换 json 格式 - res.end (): 向客户端发送指定的内容,并结束这次请求的处理过程,这里可以传参数也可以不传参数,如果
传参:就是向客户端发送指定的内容,并结束这次请求的处理过程;如果不传参:就是直接结束这次请求的处理过程。
# setHeader 和 writeHead
-
都是设置请求头的方法
-
这两个都必须写在
res.end()之前 -
response.setHeader () 只允许您设置单个标题
var body = "hello world"; response.setHeader("Content-Length", body.length); response.setHeader("Content-Type", "text/plain"); response.setHeader("Set-Cookie", "type=ninja"); response.status(200); -
response.writeHead () 将允许您设置有关响应头的所有内容,包括状态代码,内容和多个标头
var body = "hello world"; response.writeHead(200, { "Content-Length": body.length, "Content-Type": "text/plain", "Set-Cookie": "type=ninja", }); -
同时出现 setHeader 和 writeHead,setHeader 会合并到 writeHead,并且 writeHead 优先级高
-
writeHead 可以设状态码和状态信息,setHeader 不能设置,只能设置标头
-
setHeader 可以重复调用,writeHead 只能调用一次
# CORS
-
案例
const http = require("http");
http
  .createServer((req, res) => {
    res.wirteHead(200, {
      "Content-Type": "application/json;charset=utf-8",
      // cors 响应头
      "access-control-allow-origin": "*",
    });
    // 业务逻辑
    ...
    //结束
    res.end()
  })
  .listen(3000);
# https 模块充当中间件
比如从前端请求其他网站的数据,这里以美团为例,Node 充当客户端的角色,以中间件的形式去跟美团请求,然后将结果从 Node 返回给前端
-
get
var http = require("http"); var https = require("https"); var url = require("url"); http .createServer((req, res) => { var urlobj = url.parse(req.url, true); // console.log(urlobj.query.callback) res.writeHead(200, { "Content-Type": "application/json;charset=utf-8", //cors头, "access-control-allow-origin": "*", }); switch (urlobj.pathname) { case "/api/aaa": //客户端 去猫眼要数据 httpget((data) => { res.end(data); }); break; default: res.end("404"); } }) .listen(3000); function httpget(cb) { var data = ""; https.get( `https://i.maoyan.com/api/mmdb/movie/v3/list/hot.json?ct=%E5%8C%97%E4%BA%AC&ci=1&channelId=4`, (res) => { res.on("data", (chunk) => { // 这里是请将请求结果一点一点的合到一起 data += chunk; }); res.on("end", () => { console.log(data); cb(data); // response.end(data) }); } ); } -
post
var http = require("http");
var https = require("https");
var url = require("url");

http
  .createServer((req, res) => {
    var urlobj = url.parse(req.url, true);
    // console.log(urlobj.query.callback)

    res.writeHead(200, {
      "Content-Type": "application/json;charset=utf-8",
      //cors头,
      "access-control-allow-origin": "*",
    });

    switch (urlobj.pathname) {
      case "/api/aaa":
        //客户端 去小米优品要数据
        httppost((data) => {
          res.end(data);
        });
        break;
      default:
        res.end("404");
    }
  })
  .listen(3000);

function httppost(cb) {
  var data = "";

  var options = {
    hostname: "m.xiaomiyoupin.com",
    port: "443",
    path: "/mtop/market/search/placeHolder",
    method: "POST",
    headers: {
      "Content-Type": "application/json",

      // "Content-Type":"x-www-form-urlencoded"
    },
  };
  var req = https.request(options, (res) => {
    res.on("data", (chunk) => {
      data += chunk;
    });
    res.on("end", () => {
      cb(data);
    });
  });
  // req.write("name=kerwin&age=100")
  // 这个是小米优品那个接口的入参 [{}, { baseParam: { yqClient: 1 } }]

  req.write(JSON.stringify([{}, { baseParam: { ypClient: 1 } }]));
  req.end();
}
# http 爬虫
npm i cheerio: 安装解析 HTML 的包
-
爬虫
var http = require("http");
var https = require("https");
var url = require("url");

var cheerio = require("cheerio");

http
  .createServer((req, res) => {
    var urlobj = url.parse(req.url, true);
    res.writeHead(200, {
      "Content-Type": "application/json;charset=utf-8",
      "access-control-allow-origin": "*",
    });

    switch (urlobj.pathname) {
      case "/api/aaa":
        //客户端 去猫眼要数据
        httpget((data) => {
          res.end(spider(data));
        });
        break;
      default:
        res.end("404");
    }
  })
  .listen(3000);

function httpget(cb) {
  var data = "";
  https.get(`https://i.maoyan.com/`, (res) => {
    res.on("data", (chunk) => {
      data += chunk;
    });

    res.on("end", () => {
      console.log(data);
      cb(data);
    });
  });
}

// 这里就是爬虫
function spider(data) {
  // npm i cheerio
  let $ = cheerio.load(data);

  let $movielist = $(".column.content");
  let movies = [];

  $movielist.each((index, value) => {
    movies.push({
      title: $(value).find(".title").text(), // 将电影名字过滤出来
      grade: $(value).find(".grade").text(), // 将电影评分过滤出来
      actor: $(value).find(".actor").text(), // 将电影主演过滤出来
    });
  });

  return JSON.stringify(movies);
}
# url 模块
# 旧版,已经被废弃了
-
案例 1:parse
const url = requuire("url"); console.log(url.parse(req.url)); // 会输出 search,query,pathname,path,href 等属性 console.log(url.parse(req.url, true)); // 加了 true 之后,返回的 query 是一个转换好之后的对象 -
案例 2:format
const url = require("url"); const urlObj = { protocol: "https:", slashes: true, auth: null, host: "www.baidu.com:443", port: "443", hostname: "www.baidu.com", hash: "#tag=110", search: "?id=8&name=mouse", query: { id: "8", name: "mouse" }, pathname: "/ad/index.html", path: "/ad/index.html?id=8&name=mouse", }; const parseObj = url.format(urlObj); // 结果:https://www.baidu.com:443/ad/index.html?id=8&name=mouse#tag=110 url.parse("https://www.baidu.com:443/ad/index.html?id=8&name=mouse#tag=110"); // 结果就是上边的大对象 -
案例 3:resolve
const url = require("url");
let a = url.resolve("/one/two/three", "four");
// /one/two/four
let a = url.resolve("/one/two/three/", "four");
// /one/two/three/four
let a = url.resolve("http://example.com/", "/one");
// http://example.com/one
let a = url.resolve("http://example.com/aaa", "/one");
// http://example.com/one
let a = url.resolve("http://example.com/aaa/bbbb", "/one");
// http://example.com/one
# 新版
# querystring 模块
-
案例
const qs = require("querystring");
const str = "name=mrr&age=100&location=bj";
qs.parse(str);
// 通过 querystring 模块的 parse 方法可以把查询字符串解析成对象的格式
// {name:'mrr',age:'100',locatoin:'bj'}

const obj = { a: 1, b: 2, c: 3 };
qs.stringify(obj); // a=1&b=2&c=3

// escape/unescape:对特殊符号进行一个转义(防止sql的注入)/对特殊符号进行转换
let str1 = "id=3&city=北京&url=https://www.baidu.com";
let escaped = qs.escape(str1);
// id%3D3%26city%3D%E5%8C%97%E4%BA%AC%26url%3Dhttps%3A%2F%2Fwww.baidu.com

let str2 =
  "id%3D3%26city%3D%E5%8C%97%E4%BA%AC%26url%3Dhttps%3A%2F%2Fwww.baidu.com";
let unescaped = qs.unescaped(str2);
// id=3&city=北京&url=https://www.baidu.com
# event 模块
其实就是发布订阅者模式
-
event.js
const EventEmitter = require("events"); const event = new EventEmitter(); event.on("play", (data) => { console.log("事件触发了-play", data); }); event.on("play", (data) => { console.log("事件触发了-play", data); }); event.on("play", (data) => { console.log("事件触发了-play", data); }); event.on("play", (data) => { console.log("事件触发了-play", data); }); event.on("run", (data) => { console.log("事件触发了--run", data); }); setTimeout(() => { event.emit("play", "11111111"); }, 2000); -
get.js
const { EventEmitter } = require("events");
var http = require("http");
var https = require("https");
var url = require("url");

var event = null;
http
  .createServer((req, res) => {
    var urlobj = url.parse(req.url, true);
    res.writeHead(200, {
      "Content-Type": "application/json;charset=utf-8",
      "access-control-allow-origin": "*",
    });

    switch (urlobj.pathname) {
      case "/api/aaa":
        //客户端 去猫眼要数据
        event = new EventEmitter();
        // 在这里 new 的原因是,如果在最上方就 new 的话,在底下 emit 的时候会每次都执行一次,因为没有销毁。在这里 new 的话,event 一直都是最新的
        // 和定时器差不多,每次用完都应该销毁
        event.on("play", (data) => {
          console.log(11111);
          res.end(data);
        });
        httpget();
        break;
      default:
        res.end("404");
    }
  })
  .listen(3000);

function httpget(cb) {
  var data = "";
  https.get(
    `https://i.maoyan.com/api/mmdb/movie/v3/list/hot.json?ct=%E5%8C%97%E4%BA%AC&ci=1&channelId=4`,
    (res) => {
      res.on("data", (chunk) => {
        data += chunk;
      });

      res.on("end", () => {
        event.emit("play", data);
      });
    }
  );
}
# 模块化
# 基本概念
模块化 是指解决一个 复杂问题 时,自顶向下逐层 把系统划分成若干模块的过程 。对于整个系统来说, 模块是可组合、分解和更换的单元 。
编程领域中的模块化,就是 遵循固定的规则 ,把一个 大文件 拆成 独立并互相依赖的多个小模块 。
把代码进行模块化拆分的好处:
- 提高了代码的
复用性 - 提高了代码的
可维护性 - 可以实现
按需加载
需要遵循哪些规则,例如:
- 是用什么样的语法格式来
引用模块 - 在模块中使用什么样的语法格式
向外暴露成员
模块化规范的好处 :大家都遵守同样的模块化规范写代码,降低了沟通的成本,极大方便了各个模块之间的相互调用,利人利己。
# Node.js 中的模块
# 分类
Node.js 中根据模块来源的不同,将模块分成了 3 大类,分别是:
内置模块(内置模块是由 Node.js 官方提供的,例如 fs,path,http 等)自定义模块(用户创建的每个.js 文件,都是自定义模块)第三方模块(由第三方开发出来的模块,并非官方提供的内置模块,也不是用户创建的自定义模块,使用前需要先下载)
# 加载模块
使用强大的 require () 方法,可以加载需要的内置模块,用户自定义模块,第三方模块进行使用。例如:
// 内置模块
const fs = require("fs");
// 自定义模块
// 在使用require加载用户自定义模块期间,可以省略 .js 后缀名
const custom = require("./custom.js");
// 第三方模块
const moment = require("moment");
注意 :使用 require () 方法加载其他模块时,会执行被加载模块中的代码。
# Node.js 中的模块作用域
-
什么是模块作用域
和函数作用域类似,自定义模块中定义的变量、方法等成员,只能在当前模块内被访问,这种模块级别的访问限制,叫做模块作用域。 -
模块作用域的好处
放置了全局变量污染的问题
# 向外共享模块作用域中的成员
-
module 对象
在每个.js 自定义模块中都有一个 module 对象,它里面存储了和当前模块有关的信息 -
module.exports 对象
在自定义模块中,可以使用 module.exports 对象,将模块内的成员共享出去,供外界使用。外界用require()方法导入自定义模块时,得到的就是 module.exports 所指向的对象const age = 20; module.exports.age = age; // 向 module.exports 对象上挂载 username 属性 module.exports.username = "zs"; // 向 module.exports 对象上挂载 sayHello 方法 module.exports.sayHello = function () { console.log("Hello"); }; -
注意点
使用 require () 方法导入模块时,导入的结果,永远以 module.exports 指向的对象为准。module.exports.username = "zs"; module.exports.sayHello = function () { console.log("Hello"); }; // 这里让 module.exports 指向一个全新的对象 // require()方法导入的下边的内容 module.exports = { nickname: "小黑", sayHi() { console.log("Hi"); }, }; -
exports 对象
由于 module.exports 单词写起来比较复杂,为了简化向外共享成员的代码,Node 提供了 exports 对象。默认情况下,exports 和 module.exports 指向同一个对象。最终共享的结果,还是以module.exports指向的对象为准。 -
exports 和 module.exports 的使用误区
时刻谨记,require () 模块时,得到的永远是
module.exports指向的对象
注意:为了防止混论,建议不要在同一个模块中同时使用 exports 和 module.exports-
案例
exports.username = "zs"; module.exports = { gender: "男", age: 22, }; // require 导入的是 { gender: "男", age: 22}module.exports.username = "zs"; exports = { gender: "男", age: 22, }; // require 导入的是 { username: "zs"}exports.username = "zs"; module.exports.gender = "男"; // require 导入的是 { username: "zs",gender:"男"}exports = { username: "zs", gender: "男", }; module.exports = exports; module.exports.age = "22"; // require 导入的是 { username: "zs",gender:"男",age:"22"}
-
# Node.js 中的模块化规范
Node.js 遵循了 CommonJS 模块化规范,CommonJS 规定了 模块的特性 和 各模块之间如何相互依赖
CommonJS 规定:
- 每个模块内部,
module 变量代表当前模块。 - module 变量是一个对象,它的 exports 属性 (即
module.exports)是对外的接口。 - 加载某个模块,其实是加载该模块的 module.exports 属性。
require()方法用于加载模块。
# npm 与包
# 什么是包
Node.js 中的 第三方模块 又叫做 包 。
就像 电脑 和 计算机 指的是相同的东西, 第三方模块和包指的是同一个概念,只不过叫法不同 。
-
包的来源
不同于 Node.js 中的内置模块与自定义模块,包是由第三方个人或团队开发出来的,免费供所有人使用。
注意:Node.js 中的包都是免费且开源的,不需要付费即可免费下载使用。 -
为什么需要包
由于 Node.js 的内置模块仅提供了一些底层的 API,导致在基于内置模块进行项目开发的时候,效率很低。
包是基于内置模块封装出来的,提供了更高级、更方便的 API,极大的提高了开发效率。
包和内置模块之间的关系,类似于jQuery和浏览器内置 API之间的关系。 -
安装指定版本的包
通过@符号指定具体的版本npm i lodash@x.xx.x -
包的语义化版本规范
包的版本号是以 "点分十进制" 形式进行定义的,总共有三位数字,例如2.11.1
其中每一位数字所代表的含义如下:
第一位数字:大版本
第二位数字:功能版本
第三位数字:Bug修复版本版本号提升的规则:只要前面的版本号增长了,则后面的版本号归零
# 包管理配置文件
npm 规定,在 项目根目录 中,必须提供一个叫做 package.json 的包管理配置文件,用来记录与项目有关的一些配置信息,例如:
- 项目的名称,版本号,描述等
- 项目中都用到了哪些包
- 哪些包只在
开发期间会用到 - 哪些包在
开发和部署时都需要用到
注意:今后在项目开发中,一定要把 node_modules 文件夹,添加到 .gitignore 忽略文件中。
-
快速创建 package.json
可以在执行命令时所处的目录中,快速创建 package.json 这个包管理配置文件。npm init -y; // 即可快速创建 package.json 文件上述命令
只能在英文的目录下成功运行!所以,项目文件夹的名称一定要使用英文命名,不要使用中文,不能出现空格。
运行 npm install 命令安装包的时候,npm 包管理工具会自动把包的名称和版本号,记录到 package.json 中。 -
dependencies 节点
专门用来记录您使用 npm install 命令安装了哪些包 -
一次性安装所有的包
可以运行npm instal或者 (npm i) 一次性安装所有的依赖包。
执行 npm install 命令时,npm 包管理工具会先读取 package.json 中的 dependencies 节点。读取到记录的所有依赖包名称和版本号之后,npm 包管理工具会把这些包一次性下载到项目中。 -
卸载包
npm uninstall 包名
这个命令执行完之后,会把卸载的包自动从 package.json 的 dependencies 中移除掉。 -
devDependencies 节点
如果某些包只在项目开发阶段会用到,在项目上线之后不会用到,则建议把这些包记录到 devDependencies 节点中。
与之对应的,如果某些包在开发和项目上线之后都需要用到,则建议把这些包记录到 dependencies 节点中。
您可以使用如下的命令:将包记录到 devDependencies 节点中:npm i 包名 -D // 或者 npm i 包名 --save-dev -
解决下包速度慢的问题
-
可以使用淘宝镜像,这里是手动设置的命令:npm config set registry https://registry.npm.taobao.org
-
可以使用 nrm
为了更方便的切换下包的镜像源,我们可以安装 nrm 这个工具,利用 nrm 提供的终端命令,可以快速查看和切换下包的镜像源。npm i nrm -g nrm --verion nrm ls nrm use taobao
-
# 包的分类
-
项目包
那些被安装到项目的 node_modules 目录中的包,都是项目包。
项目包又分为两类,分别是:- 开发依赖包:被记录到 devDependencies 节点中的包,只在开发期间会用到
- 核心依赖包:被记录到 dependencies 节点中的包,在开发期间和项目上线之后都会用到
npm i 包名 -D // 开发依赖包 devDependencies npm i 包名 // 核心依赖包 dependencies -
全局包
在执行 npm install 命令时 ,如果提供了 -g 参数,则会把包安装为全局包。
npm i 包名 -g // 安装
npm uninstall 包名 -g //卸载
注意:只有
工具性质的包,才有全局安装的必要性,因为他们提供了好用的终端命令。判断某个包是否需要全局安装后才能使用,可以参考官方提供的使用说明即可。
# 规范的包结构
一个规范的包,它的组成结构,必须符合以下 3 个要求:
- 包必须以
单独的目录而存在 - 包的顶级目录下要必须包含
package.json这个包管理配置文件 - package.json 中必须包含
name,version,main这三个属性,分别代表包的名字,版本号,包的入口
# 开发属于自己的包 (mrrTestNpm)
必须有三个文件:(package.json,index.js,readme.md)
-
package.json (包管理配置文件)
{ // 包的名称是 package.json 中的 name 指定的 "name": "mrrTestNpm", "version": "1.0.1", // 入口文件 "main": "index.js", // 用户搜索这个包的时候,用户可以看到这个描述信息 "description": "提供了格式化时间,HTMLEscape的功能", "keywords": ["mrr", "dateFormat", "escape"], // 开源许可协议,NPM默认的是ISC "license": "ISC" } -
src–>dateFormat.js
// 定义格式化时间的函数 function dateFormat(dataStr) { const dt = new Date(dataStr); const y = dt.getFullYear(); const m = padZero(dt.getMonth() + 1); const d = padZero(dt.getDate()); const hh = padZero(dt.getHours()); const mm = padZero(dt.getMinutes()); const ss = padZero(dt.getSeconds()); return `${y}-${m}-${d} ${hh}-${mm}-${ss}`; } // 定义一个补零的函数 function padZero(n) { return n > 9 ? n : "0" + n; } module.exports = { dateFormat, }; -
src–>htmlEscape.js
// 定义转义HTML的方法 function htmlEscape(htmlStr) { return htmlStr.replace(/<|>|"|&/g, (match) => { switch (match) { case "<": return "<"; case ">": return ">"; case '"': return """; case "&": return "&"; } }); } // 还原HTML的方法 function htmlUnEscape(str) { return str.replace(/<|>|"|&/g, (match) => { switch (match) { case "<": return "<"; case ">": return ">"; case """: return '"'; case "&": return "&"; } }); } module.exports = { htmlEscape, htmlUnEscape, }; -
index.js (包的入口文件)
// 这是包的入口文件 // 只给定文件夹,没给定要导入哪个文件,它也可以正常导入 // 因为node通过require()导入的时候,看到你没有指定具体哪个文件,就会去查找这个文件夹中有没有一个package.json的文件,有的话,去package.json中看一下有没有指定main属性,如果有的话,require的时候就会自动根据main属性来导入文件下面叫做index.js的文件 const date = require("./src/dateFormat"); const escape = require("./src/htmlEscape"); // 向外暴露需要的成员 module.exports = { ...date, ...escape, }; -
test.js
const mrrTestNpm = require("./mrrTestNpm"); // 只给定文件夹,没给定要导入哪个文件,它也可以正常导入 // 因为node通过require()导入的时候,看到你没有指定具体哪个文件,就会去查找这个文件夹中有没有一个package.json的文件,有的话,去package.json中看一下有没有指定main属性,如果有的话,require的时候就会自动根据main属性来导入文件下面叫做index.js的文件 // 测试格式化时间的功能 const str = mrrTestNpm.dateFormat(new Date()); console.log(str); const htmlStr = `<h1 title="abc">这是h1标签<span>123nbsp;</span></h1>`; const str1 = mrrTestNpm.htmlEscape(htmlStr); console.log(str1); // <h1 title="abc">这是h1标签<span>123nbsp;</span></h1> const str2 = mrrTestNpm.htmlUnEscape(str1); console.log(str2); // <h1 title="abc">这是h1标签<span>123nbsp;</span></h1> -
README.md (包的说明文档)
-
安装方式
npm i mrrTestNpm(包名) -
导入
const mrrTestNpm = require("mrrTestNpm"); -
其他说明,没有硬性要求
-
# 发布包
-
注册 npm 账号
-
登录账号
npm 账号注册完成后,可以在终端执行 npm login 命令,依次输入用户名,密码,邮箱后,即可登录成功。
注意:在运行 npm login 命令之前,必须先把下包的服务器地址切换为 npm 的官方服务器。否则会导致发布包失败。不能在其他的镜像中。nrm ls // 检查当前的环境 nrm use npm // 使用npm npm login // 依次输入用户名,密码,邮箱,邮箱发送的验证码 // 登录成功会提示:Logged in as username on https://registry.npmjs.org/. -
把包发布到 npm 上
将终端切换到包的根目录,运行
npm publish命令,即可将包发布到 npm 上 (注意:包名不能雷同,且不能有大写字母) -
删除已发布的包
在项目根目录运行
npm unpublish 包名 --force命令,即可从 npm 删除已发布的包
注意:- npm unpublish 命令只能删除 72 小时以内发布的包
- npm unpublish 删除的包,在 24 小时内不允许重复发布
- 发布包的时候慎重,尽量不要往 npm 上发布没有意义的包
# yarn
npm install -g yarn
对比 npm :
- 速度超快,Yarn 缓存了每个下载过的包,所以再次使用时无需重复下载。同时利用并行下载以最大化资源利用率,因此安装速度更快。
- 超级安全:在执行代码之前,Yarn 会通过算法校验每个安装包的完整性。
-
开始项目:yarn init
-
添加依赖包:
- yarn add [package]
- yarn add [package]@[version]
- yarn add [package] --dev
-
升级依赖包
- yarn upgrade [package]@[version]
-
移除依赖包
- yarn remove [package]
-
安装项目的全部依赖
- yarn install
# 模块的加载机制
# 优先从缓存中加载
模块在第一次加载后会被缓存 ,这也意味着多次调用 require() 不会导致模块的代码被执行多次。
注意:不论是内置模块、用户自定义模块、还是第三方模块,它们都会优先从缓存中加载,从而 提高模块的加载效率 。
# 内置模块的加载机制
内置模块是由 Node.js 官方提供的模块, 内置模块的加载优先级最高 。
例如:require ('fs) 始终返回内置的 fs 模块,即使在 node_modules 目录下有名字相同的包也叫做 fs。
# 自定义模块的加载机制
使用 require () 加载自定义模块时,必须指定以 ./ 或 ../ 开头的路径标识符。在加载自定义模块时,如果没有指定 ./ 或 ../ 这样的路径标识符,则 node 会把它当作 内置模块 或 第三方模块 进行加载。
同时,在使用 require () 导入自定义模块时,如果省略了文件的扩展名,则 Node.js 会 按顺序 分别尝试加载以下的文件:
- 按照
确切的文件名进行加载 - 补全
.js扩展名进行加载 - 补全
.json扩展名进行加载 - 补全
.node扩展名进行加载 - 加载失败,终端报错
# 第三方模块的加载机制
如果传递给 require () 的模块标识符不是一个内置模块,也没有以 ./ 或 ../ 开头,则 Node.js 会从当前模块的父目录开始,尝试从 /node_modules 文件夹中加载第三方模块。
如果没有找到对应的第三方模块,则移动到再上一层父目录中,进行加载,直到文件系统的根目录。
例如:假设在 C:\Users\mrr\project\foo.js 文件里调用了 require('tools') ,则 Node.js 会按以下顺序查找:
C:\Users\mrr\project\node_modules\toolsC:\Users\mrr\\node_modules\toolsC:\Users\node_modules\toolsC:\node_modules\tools
# 目录作为模块
当把目录作为模块标识符,传递给 require () 进行加载的时候,有三种加载方式:
- 在被加载的目录下查找一个叫做 package.json 的文件,并寻找 main 属性,作为 require () 加载的入口
- 如果目录里没有 package.json 文件,或者 main 入口不存在或无法解析,则 Node.js 将会试图加载目录下的
index.js文件。 - 如果以上两步都失败了,则 Node.js 会在终端打印错误消息,报告模块的缺失:Error:Cannot find module ‘xxx’
# ES 模块化写法
在 pckage.json 中新增一个字段: "type":"module" ,之后就可以使用 export.default= 和 export {} 以及 import 这种 Es6 的模块写法了。但是需要注意,引入的时候要写全了,比如 ././hh.js, 这里的 .js 一定要写
# stream 流模块
stream 是 Node.js 提供的又一个仅在服务端可用的模块,目的是支持 “流” 这种数据结构。
什么是流?流是一种抽象的数据结构。想象水流,当在水管中流动时,就可以从某个地方(例如自来水厂)源源不断地到达另一个地方(比如你家的洗手池)。我们也可以把数据看成是数据流,比如你敲键盘的时候,就可以把每个字符依次连起来,看成字符流。这个流是从键盘输入到应用程序,实际上它还对应着一个名字:标准输入流(stdin)。
-
利用流去读取文件数据
内存比较大的文件,可以用这种流的方式去读写var fs = require("fs"); // 打开一个流: var rs = fs.createReadStream("sample.txt", "utf-8"); rs.on("data", function (chunk) { // 要注意, data 事件可能会有多次,每次传递的 chunk 是流的一部分数据。 console.log("DATA:"); console.log(chunk); }); rs.on("end", function () { console.log("END"); }); rs.on("error", function (err) { console.log("ERROR: " + err); }); -
利用流去写文件数据
var fs = require("fs"); var ws1 = fs.createWriteStream("output1.txt", "utf-8"); // 要以流的形式写入文件,只需要不断调用 write() 方法,最后以 end() 结束: ws1.write("使用Stream写入文本数据...\n"); ws1.write("END."); ws1.end(); // 可能有一个问题:如果写的比读的快,可能会有溢出。这时候就有了管道的概念 -
pipe 管道
特别适合大型文件的复制
pipe就像可以把两个水管串成一个更长的水管一样,两个流也可以串起来。一个Readable流和一个Writable流串起来后,所有的数据自动从Readable流进入Writable流,这种操作叫pipe。
在 Node.js 中,Readable流有一个pipe()方法,就是用来干这件事的。
让我们用pipe()把一个文件流和另一个文件流串起来,这样源文件的所有数据就自动写入到目标文件里了,所以,这实际上是一个复制文件的程序:const fs = require("fs"); const readstream = fs.createReadStream("./1.txt"); const writestream = fs.createWriteStream("./2.txt"); // readstream 通过一个管道流到 可写流 writestream 中,从而实现大文件的复制功能 readstream.pipe(writestream);
# zlib 模块
浏览器解析页面的大致流程如下:
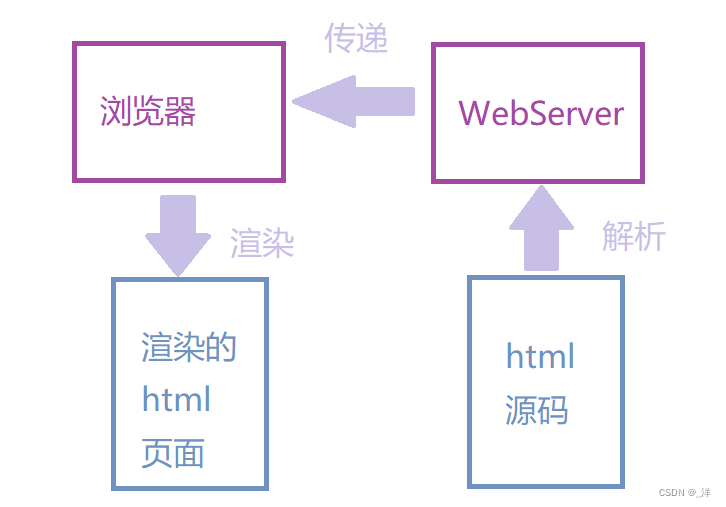
如果文件过大从 webserver 到浏览器的传输时间就会很长,所以我们可以先将文件压缩成 gzip 文件再进行传输。然后通过解压缩去进行解析下载。
压缩成 gzip 文件方法就是包含在 zlib 模块中。
-
代码:
const fs = require("fs");
const zlib = require("zlib");
const gzip = zlib.createGzip();
const readstream = fs.createReadStream("./note.txt");
const writestream = fs.createWriteStream("./note2.txt");
// 这里是压缩:pipe(gzip)
readstream.pipe(gzip).pipe(writestream);
# crypto 模块
crypto 模块的目的是为了提供通用的加密和哈希算法。用纯 JavaScript 代码实现这些功能不是不可能,
但速度会非常慢。Nodejs 用 C/C++ 实现这些算法后,通过 cypto 这个模块暴露为 JavaScript 接口,这样用
起来方便,运行速度也快。
MD5 是一种常用的哈希算法,用于给任意数据一个 “签名”。这个签名通常用一个十六进制的字符串表
示:
const crypto = require("crypto");
const hash = crypto.createHash("md5");
// const hash = crypto.createHash("sha1");
// 可任意多次调用update():
hash.update("Hello, world!");
hash.update("Hello, nodejs!");
// digest这里是要换成的格式,hex代表是十六进制格式的,还可以是base64等其他格式
console.log(hash.digest("hex"));
update() 方法默认字符串编码为 UTF-8 ,也可以传入 Buffer。
如果要计算 SHA1,只需要把 ‘md5’ 改成 ‘sha1’ ,就可以得到 SHA1 的结果
1f32b9c9932c02227819a4151feed43e131aca40 。
Hmac 算法也是一种哈希算法,它可以利用 MD5 或 SHA1 等哈希算法。不同的是,Hmac 还需要一个密
钥:
const crypto = require("crypto");
// sha256这个参数代表要加密的方式,secret-key代表密钥,这里也可以换方式也可以换密钥
const hmac = crypto.createHmac("sha256", "secret-key");
hmac.update("Hello, world!");
hmac.update("Hello, nodejs!");
console.log(hmac.digest("hex")); // 80f7e22570...
只要密钥发生了变化,那么同样的输入数据也会得到不同的签名,因此,可以把 Hmac 理解为用随机数
“增强” 的哈希算法。
AES 是一种常用的对称加密算法,加解密都用同一个密钥。crypto 模块提供了 AES 支持,但是需要自己
封装好函数,便于使用:
const crypto = require("crypto");
function encrypt(key, iv, data) {
  // aes-128-cbc这个参数代表哪一种加密算法(加密和解密一定要用同一种算法),key是用于加密的密钥,iv可选,用于指定加密时候所用的向量
  // 注意这里的密钥必须是 8/16/32位,如果加密算法是128,则对应的密钥是16位,如果加密算法是256,则对应的密钥是32位。
  let decipher = crypto.createCipheriv("aes-128-cbc", key, iv);
  // decipher.setAutoPadding(true);
  // 第一个是原始数据,第二个是输入数据的编码格式(binary代表二进制),第三个表示返回的格式(hex代表十六进制)
  // final 表示结束了
  return decipher.update(data, "binary", "hex") + decipher.final("hex");
}

// crypted 是加密之后的数据
function decrypt(key, iv, crypted) {
  // 对加密之后的数据进行处理:表示要把加密后的数据既然是16进制编码的,那就转换成Buffer对象,然后再转成二进制的格式
  // 因为加密的时候是16进制,所以这里处理的也是16进制,只不过最后转成了二进制的
  crypted = Buffer.from(crypted, "hex").toString("binary");
  // createDecipheriv 解密方法
  let decipher = crypto.createDecipheriv("aes-128-cbc", key, iv);
  return decipher.update(crypted, "binary", "utf8") + decipher.final("utf8");
}
// 16 Btye * 8 = 128 bit
// 这里设置的是aes-128-cbc(aes的128位的加密算法),所以key, iv必须是16个字节;
let key = "abcdef1234567890";
let iv = "tbcdey1234567890";
// 原始数据
let data = "mrr";
let cryted = encrypt(key, iv, data); // 加密结果

let decrypted = decrypt(key, iv, cryted); // 解密结果

// 可以看出,加密后的字符串通过解密又得到了原始内容。
# 路由
-
基础
-
server.js
let http = require("http"); const route = require("./route"); http .createServer((req, res) => { let myUrl = new URL(req.url, "http://127.0.0.1"); console.log("req", myUrl.pathname); // route[myUrl.pathname] route(res, myUrl.pathname); res.end(); }) .listen(3000, () => { console.log("success"); }); -
route.js
var fs = require("fs");
var path = require("path");
function render(res, path) {
  res.writeHead(200, { "Content-Type": "text/html;charset=utf8" });
  res.write(fs.readFileSync(path, "utf8"));
  res.end();
}
const route = {
  "/login": (req, res) => {
    render(res, "./static/login.html");
  },
  "/home": (req, res) => {
    render(res, "./static/home.html");
  },
  "/404": (req, res) => {
    res.writeHead(404, { "Content-Type": "text/html;charset=utf8" });
    res.write(fs.readFileSync("./static/404.html", "utf8"));
  },
};
-
-
获取参数
-
get 请求
"/api/login":(req,res)=>{ const myURL = new URL(req.url, 'http://127.0.0.1:3000'); console.log(myURL.searchParams.get("username")) render(res,`{ok:1}`) } -
post 请求
"/api/login": (req, res) => {
  var post = '';
  // 通过req的data事件监听函数,每当接受到请求体的数据,就累加到post变量中
  req.on('data', function (chunk) {
    post += chunk;
  });
  // 在end事件触发后,通过querystring.parse将post解析为真正的POST请求格式,然后向客户端返回。
  req.on('end', function () {
    post = JSON.parse(post);
    render(res, `{ok:1}`)
  });
}
-